
Downloads · 30 days
0
maxliaops/stable-diffusion-v-1-4-original
stable-diffusion-v-1-4-original is a text-to-image model from maxliaops. Use it when you need an image from a text prompt. It is set up for stable-diffusion. The card lists the license as creativeml-openrail-m.
Downloads · 30 days
0
Access
Public
Updated Mar 28, 2024
Repo size
—
Likes
0
Public
Click a slice to open those files.
.md10.6 KB · 88%
From the Hugging Face model README
稳定扩散是一种潜在的文本到图像扩散模型,能够根据任何文本输入生成逼真的照片。
Stable-Diffusion-v-1-4 检查点是使用Stable-Diffusion-v-1-2 检查点的权重进行初始化的,并在“laion-aesthetics v2 5+”上以 512x512 的分辨率进行了 225k 步的微调,并且丢弃了10%的文本条件,以改进无分类器引导采样。
这些权重旨在与原始的CompVis 稳定扩散代码库一起使用。如果您正在寻找与 Diffusers 库一起使用的模型,请点击这里。
开发者:Robin Rombach, Patrick Esser
模型类型:基于扩散的文本到图像生成模型
语言:英语
许可证:创意 ml OpenRAIL M 许可证是一种开放 RAIL M 许可证,改编自BigScience和RAIL 倡议在负责任的人工智能许可领域共同开展的工作。另见关于我们许可证所基于的BLOOM 开放 RAIL 许可证的文章。
模型描述:这是一个可以根据文本提示生成和修改图像的模型。它是一种潜在扩散模型,使用固定的、预训练的文本编码器(CLIP ViT-L/14),如Imagen 论文中所建议的。
更多信息资源:GitHub 存储库,论文。
引用方式:
@InProceedings{Rombach_2022_CVPR,
    author    = {Rombach, Robin and Blattmann, Andreas and Lorenz, Dominik and Esser, Patrick and Ommer, Bj\"orn},
    title     = {High-Resolution Image Synthesis With Latent Diffusion Models},
    booktitle = {Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR)},
    month     = {June},
    year      = {2022},
    pages     = {10684-10695}
}
该模型仅用于研究目的。可能的研究领域和任务包括
以下是不允许的使用方式。
_注意:本节内容取自 DALLE-MINI 模型卡,但对 Stable Diffusion v1 同样适用。
模型不应被用于故意创建或传播给人们造成敌对或疏远环境的图像。这包括生成人们可预见会感到不安、痛苦或冒犯的图像;或传播历史或当前的刻板印象内容。
该模型并没有被训练成对人或事件的真实或事实性的表示,因此使用该模型生成此类内容超出了该模型的能力范围。
使用该模型生成对个人残忍的内容是对该模型的滥用。这包括但不限于:
虽然图像生成模型的能力令人印象深刻,但它们也可能强化或加剧社会偏差。 Stable Diffusion v1 在LAION-2B(en)的子集上进行了训练, 该子集主要由仅限英语描述的图像组成。 使用其他语言的社区和文化的文本和图像可能没有得到充分考虑。 这影响了模型的整体输出,因为白色和西方文化往往被设置为默认值。此外, 模型生成非英语提示内容的能力明显不如英语提示。
训练数据 模型开发者使用以下数据集来训练模型:
训练过程 Stable Diffusion v1 是一种潜在扩散模型,它将自动编码器与在自动编码器的潜在空间中训练的扩散模型相结合。在训练期间,
我们目前提供三个检查点,sd-v1-1.ckpt、sd-v1-2.ckpt和sd-v1-3.ckpt,
它们的训练方式如下,
sd-v1-1.ckpt:在laion2B-en上以256x256的分辨率进行 237k 步。
在laion-high-resolution上以512x512的分辨率进行 194k 步(来自 LAION-5B 的 1.7 亿个示例,分辨率>= 1024x1024)。
sd-v1-2.ckpt:从sd-v1-1.ckpt恢复。
在“laion-improved-aesthetics”上以512x512的分辨率进行 515k 步(laion2B-en 的一个子集,过滤为原始尺寸>= 512x512的图像,估计的美学评分>5.0,估计的水印概率<0.5。水印估计来自 LAION-5B 元数据,美学评分使用改进的美学估计器进行估计)。
sd-v1-3.ckpt:从sd-v1-2.ckpt恢复。在“laion-improved-aesthetics”上以512x512的分辨率进行 195k 步,并将文本条件的下降率降低 10%,以改进无分类器引导采样。
硬件:32 x 8 x A100 GPU
优化器:AdamW
梯度积累:2
批次:32 x 8 x 2 x 4 = 2048
学习率:预热至 0.0001 10000 步,然后保持不变
使用不同的无分类器引导尺度(1.5、2.0、3.0、4.0、5.0、6.0、7.0、8.0)和 50 个 PLMS 采样步骤进行的评估显示了检查点的相对改进:
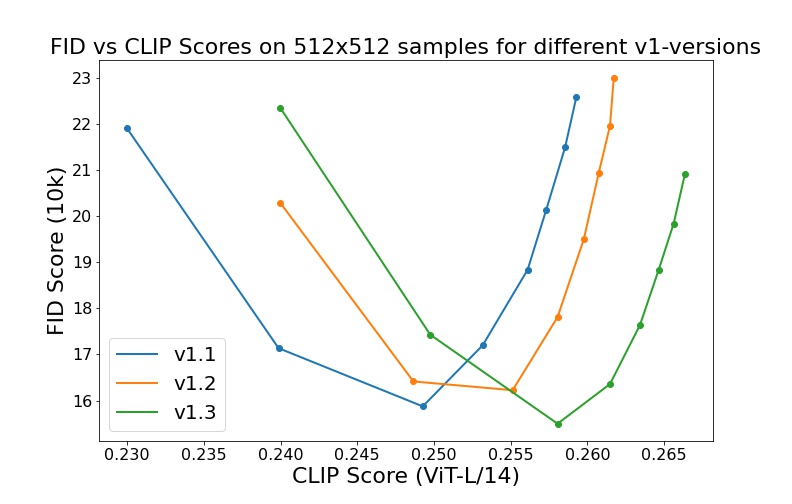
使用 50 个 PLMS 步骤和来自 COCO2017 验证集的 10000 个随机提示进行评估,在 512x512 分辨率下进行评估。未针对 FID 分数进行优化。
Stable Diffusion v1 估计排放量 根据这些信息,我们使用Lacoste 等人(2019)中提出的机器学习影响计算器估计以下 CO2 排放量。硬件、运行时间、云提供商和计算区域用于估计碳影响。
    @InProceedings{Rombach_2022_CVPR,
        author    = {Rombach, Robin and Blattmann, Andreas and Lorenz, Dominik and Esser, Patrick and Ommer, Bj\"orn},
        title     = {High-Resolution Image Synthesis With Latent Diffusion Models},
        booktitle = {Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR)},
        month     = {June},
        year      = {2022},
        pages     = {10684-10695}
    }
本模型卡由罗宾·罗巴赫和帕特里克·埃塞尔撰写,并基于DALL-E Mini 模型卡。