
Downloads · 30 days
319
10% of all-time downloads
inkoziev/charllama-35M
charllama-35M is a text generation model from inkoziev. Use it when you need the model to write or continue text. It is set up for transformers. The card lists the license as openrail.
Это крошечная языковая модель, имеющая архитектуру LLaMa, с посимвольной токенизацией для всевозможных экспериментов, когда задача решается плохо из-за BPE токенизации на слова и их части:
Downloads · 30 days
319
10% of all-time downloads
All-time downloads
3.1K
Public
Repo size
575 MB
Likes
6
Public
Click a slice to open those files.
.bin144 MB · 100%
From the Hugging Face model README
Это крошечная языковая модель, имеющая архитектуру LLaMa, с посимвольной токенизацией для всевозможных экспериментов, когда задача решается плохо из-за BPE токенизации на слова и их части:
TfidfVectorizer(analyzer='char'), т.е. когда хорошо сработал бейзлайн на символьных n-граммахРазмер модели - 35 913 600 параметров.
Я делал эту модель для экспериментов с русской поэзией в рамках проекта "Литературная студия". Поэтому корпус претрейна содержал значительное количество текстов поэтического формата. Это может повлиять на ваши downstream задачи.
Объем корпуса претрейна - около 80B токенов, тексты только на русском языке.
Кривая обучения: 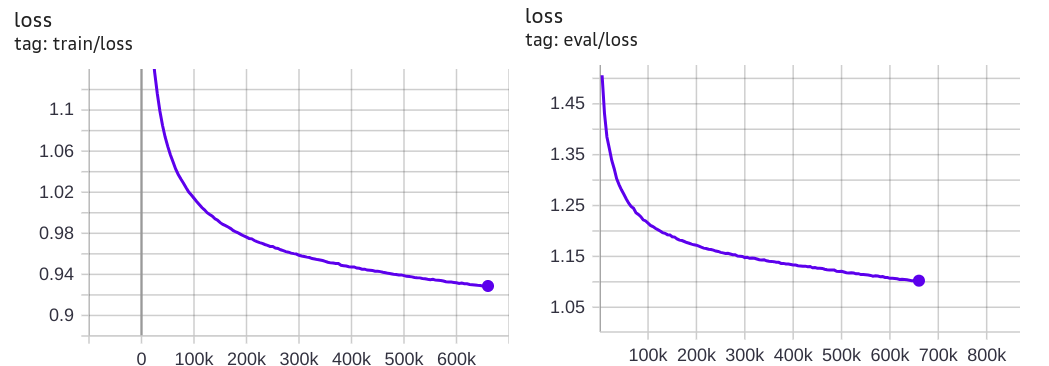
Для использования модели нужно установить специальный токенизатор:
pip install git+https://github.com/Koziev/character-tokenizer
Кроме символов кириллицы и пунктуации, этот токенизатор знает про специальные токены <s>, </s>, <pad> и <unk>.
Так как это нестандартный для transformers токенизатор, его надо загружать не через transformers.AutoTokenizer.from_pretrained, а примерно так:
import charactertokenizer

...
tokenizer = charactertokenizer.CharacterTokenizer.from_pretrained('inkoziev/charllama-35M')
Чтобы посмотреть на токенизацию, можно использовать такой фрагмент кода:
prompt = '<s>У Лукоморья дуб зеленый\n'
encoded_prompt = tokenizer.encode(prompt, return_tensors='pt')
print('Tokenized prompt:', ' | '.join(tokenizer.decode([t]) for t in encoded_prompt[0]))
Вы увидите список токенов, разделенных символом |:
Tokenized prompt: <s> | У | | Л | у | к | о | м | о | р | ь | я | | д | у | б | | з | е | л | е | н | ы | й |
С библиотекой transformerts модель можно использовать штатным способом как обычную GPT'шку (точнее, transformers.LlamaModel):
import os
import torch
import transformers
import charactertokenizer

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

model_name_or_path = 'inkoziev/charllama-35M'
model = transformers.AutoModelForCausalLM.from_pretrained(model_name_or_path)
model.to(device)
model.eval()

tokenizer = charactertokenizer.CharacterTokenizer.from_pretrained(model_path)

prompt = 'Меня зовут Ар'
encoded_prompt = tokenizer.encode(prompt, return_tensors='pt')

output_sequences = model.generate(
    input_ids=encoded_prompt.to(device),
    max_length=500,
    temperature=1.0,
    top_k=0,
    top_p=0.8,
    repetition_penalty=1.0,
    do_sample=True,
    num_return_sequences=5,
    pad_token_id=0,
)

for o in output_sequences:
    text = tokenizer.decode(o)
    if text.startswith('<s>'):
        text = text.replace('<s>', '')
    text = text[:text.index('</s>')].strip()
    print(text)
    print('-'*80)
Также, будут работать все прочие инструменты для GPT моделей, например transformers.AutoModelForSequenceClassification.