
Downloads · 30 days
206
3% of all-time downloads
alibaba-pai/CogVideoX-Fun-2b-InP
CogVideoX-Fun-2b-InP is a image-to-video model from alibaba-pai. Use it for the image-to-video task on the model card, and read the license before you ship it in a product. It is set up for videox_fun. The card lists the license as other.
Downloads · 30 days
206
3% of all-time downloads
All-time downloads
6.7K
Public
Repo size
13.3 GB
Likes
23
Public
Click a slice to open those files.
.safetensors13.3 GB · 100%
From the Hugging Face model README
😊 Welcome!
English | 简体中文
CogVideoX-Fun是一个基于CogVideoX结构修改后的的pipeline,是一个生成条件更自由的CogVideoX,可用于生成AI图片与视频、训练Diffusion Transformer的基线模型与Lora模型,我们支持从已经训练好的CogVideoX-Fun模型直接进行预测,生成不同分辨率,6秒左右、fps8的视频(1 ~ 49帧),也支持用户训练自己的基线模型与Lora模型,进行一定的风格变换。
我们会逐渐支持从不同平台快速启动,请参阅 快速启动。
新特性:
功能概览:
我们的ui界面如下:
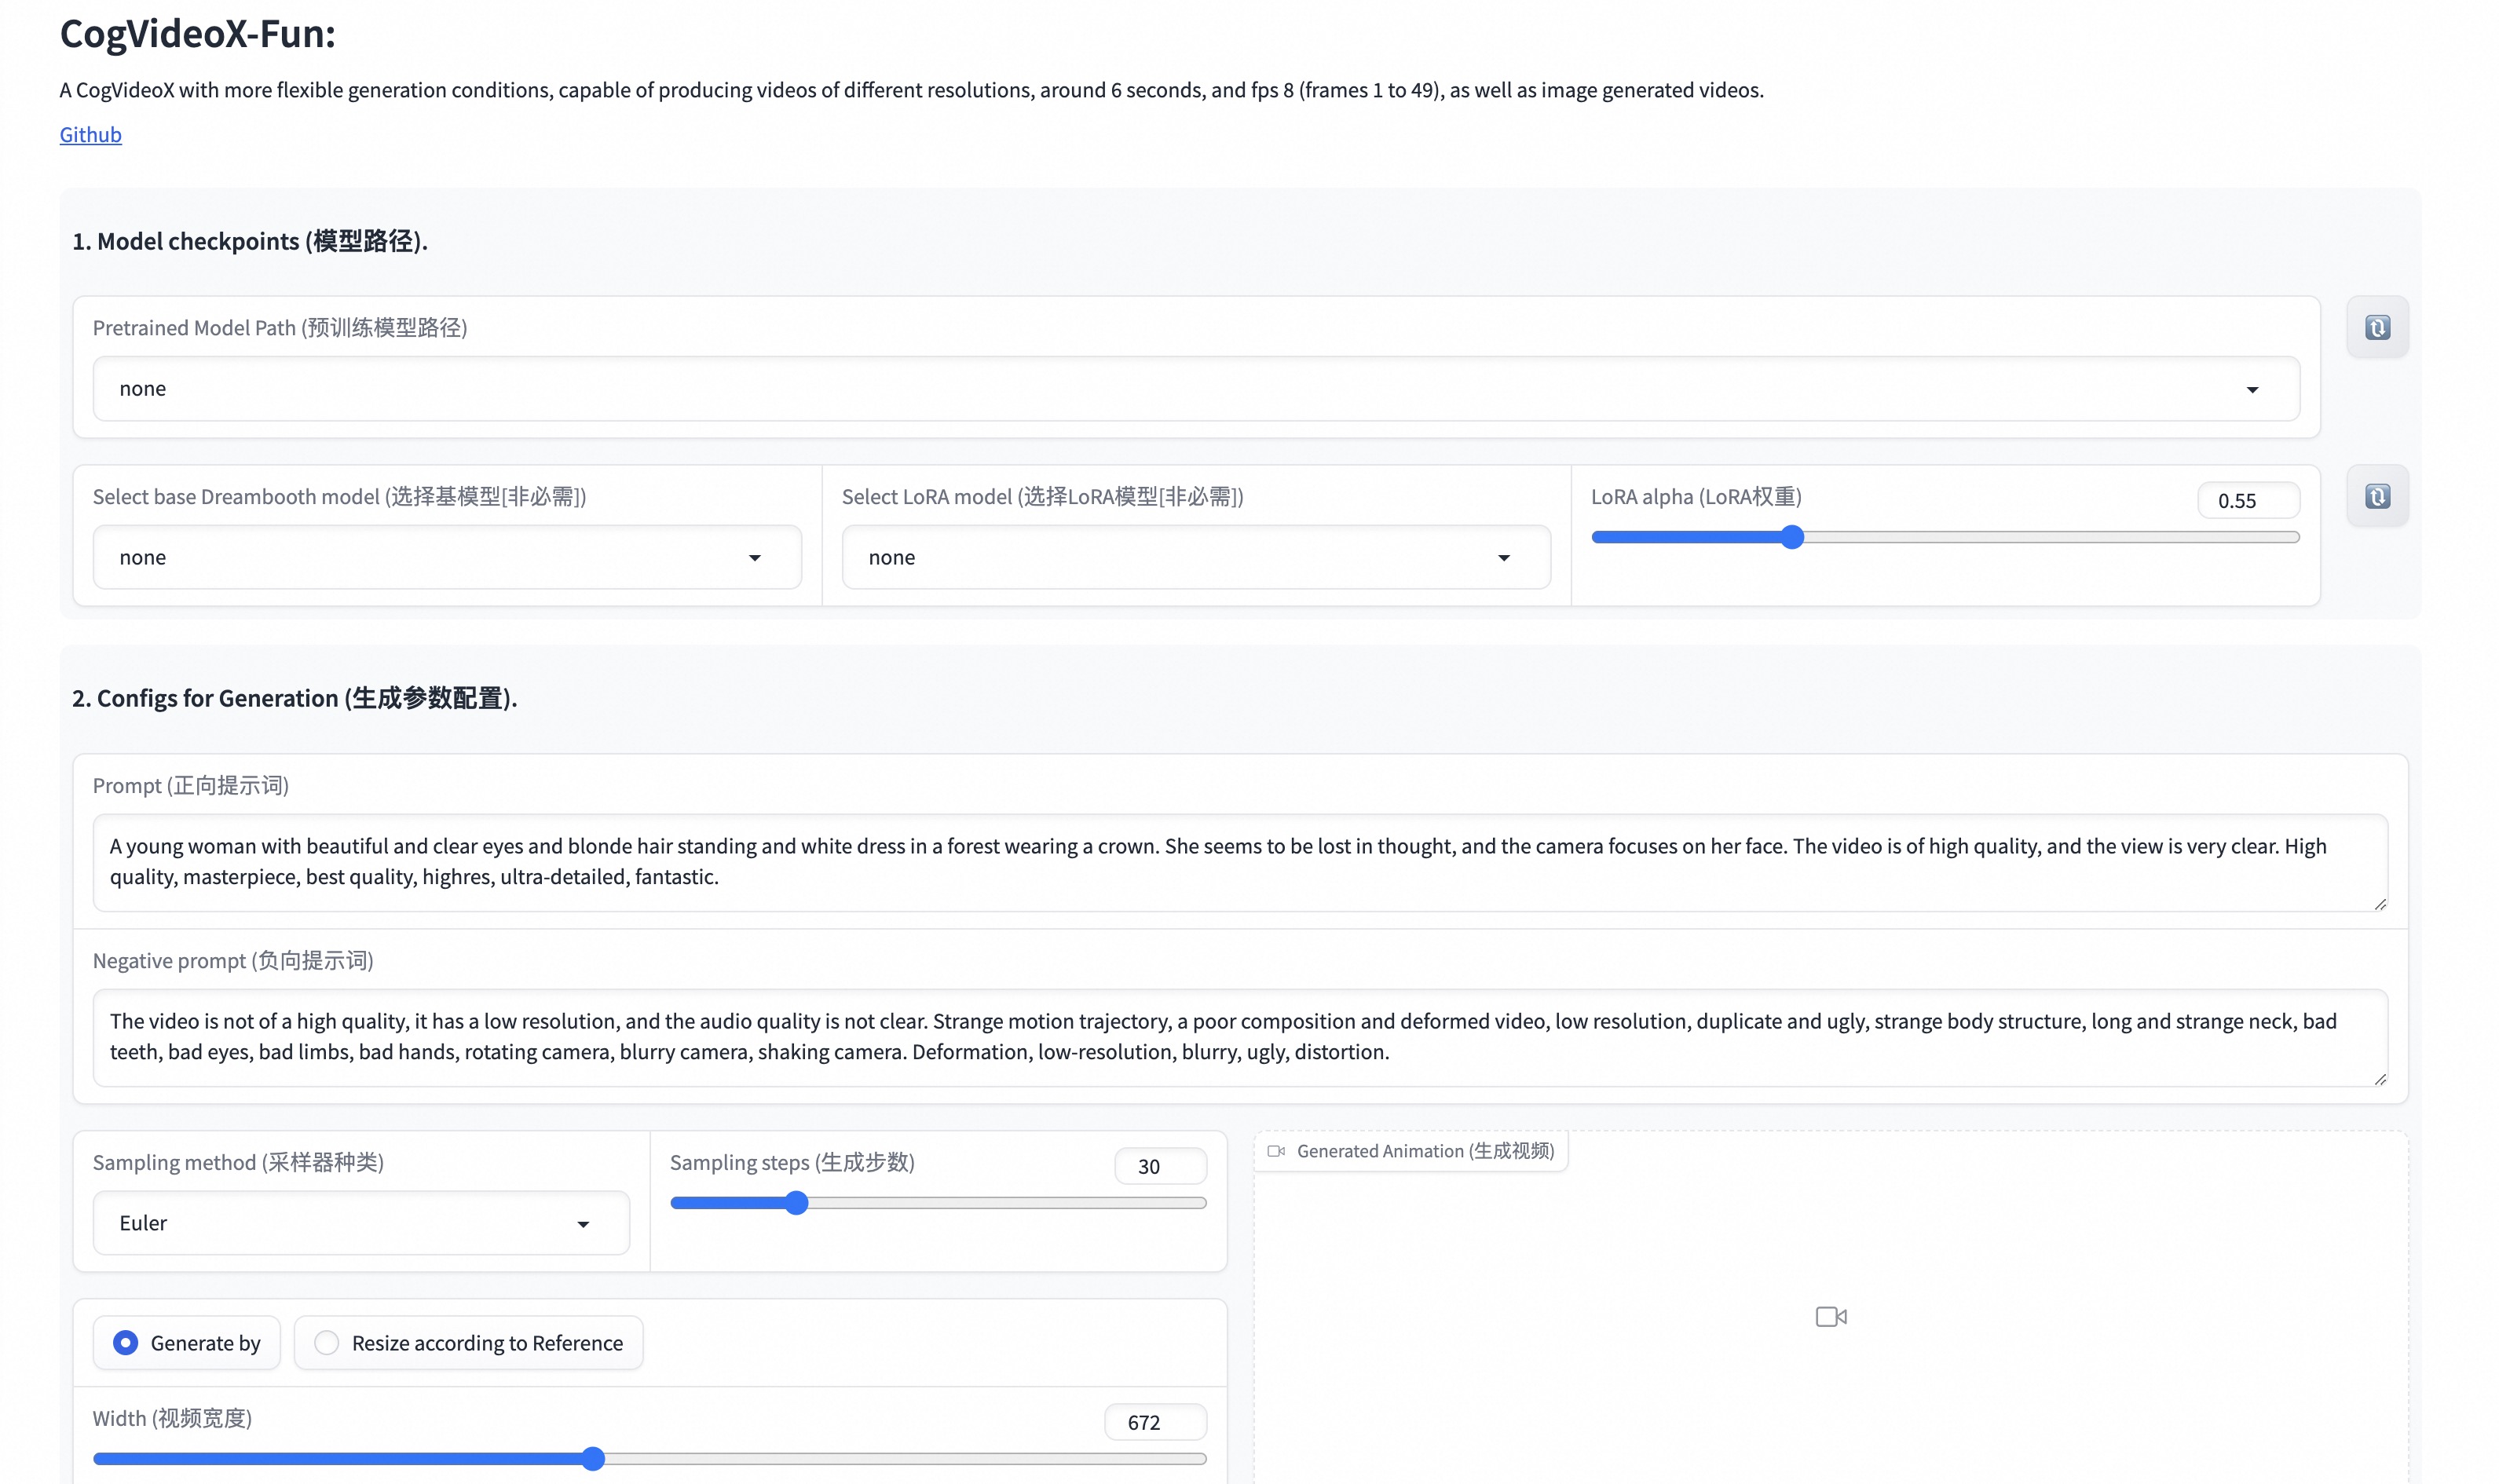
DSW 有免费 GPU 时间,用户可申请一次,申请后3个月内有效。
阿里云在Freetier提供免费GPU时间,获取并在阿里云PAI-DSW中使用,5分钟内即可启动CogVideoX-Fun。
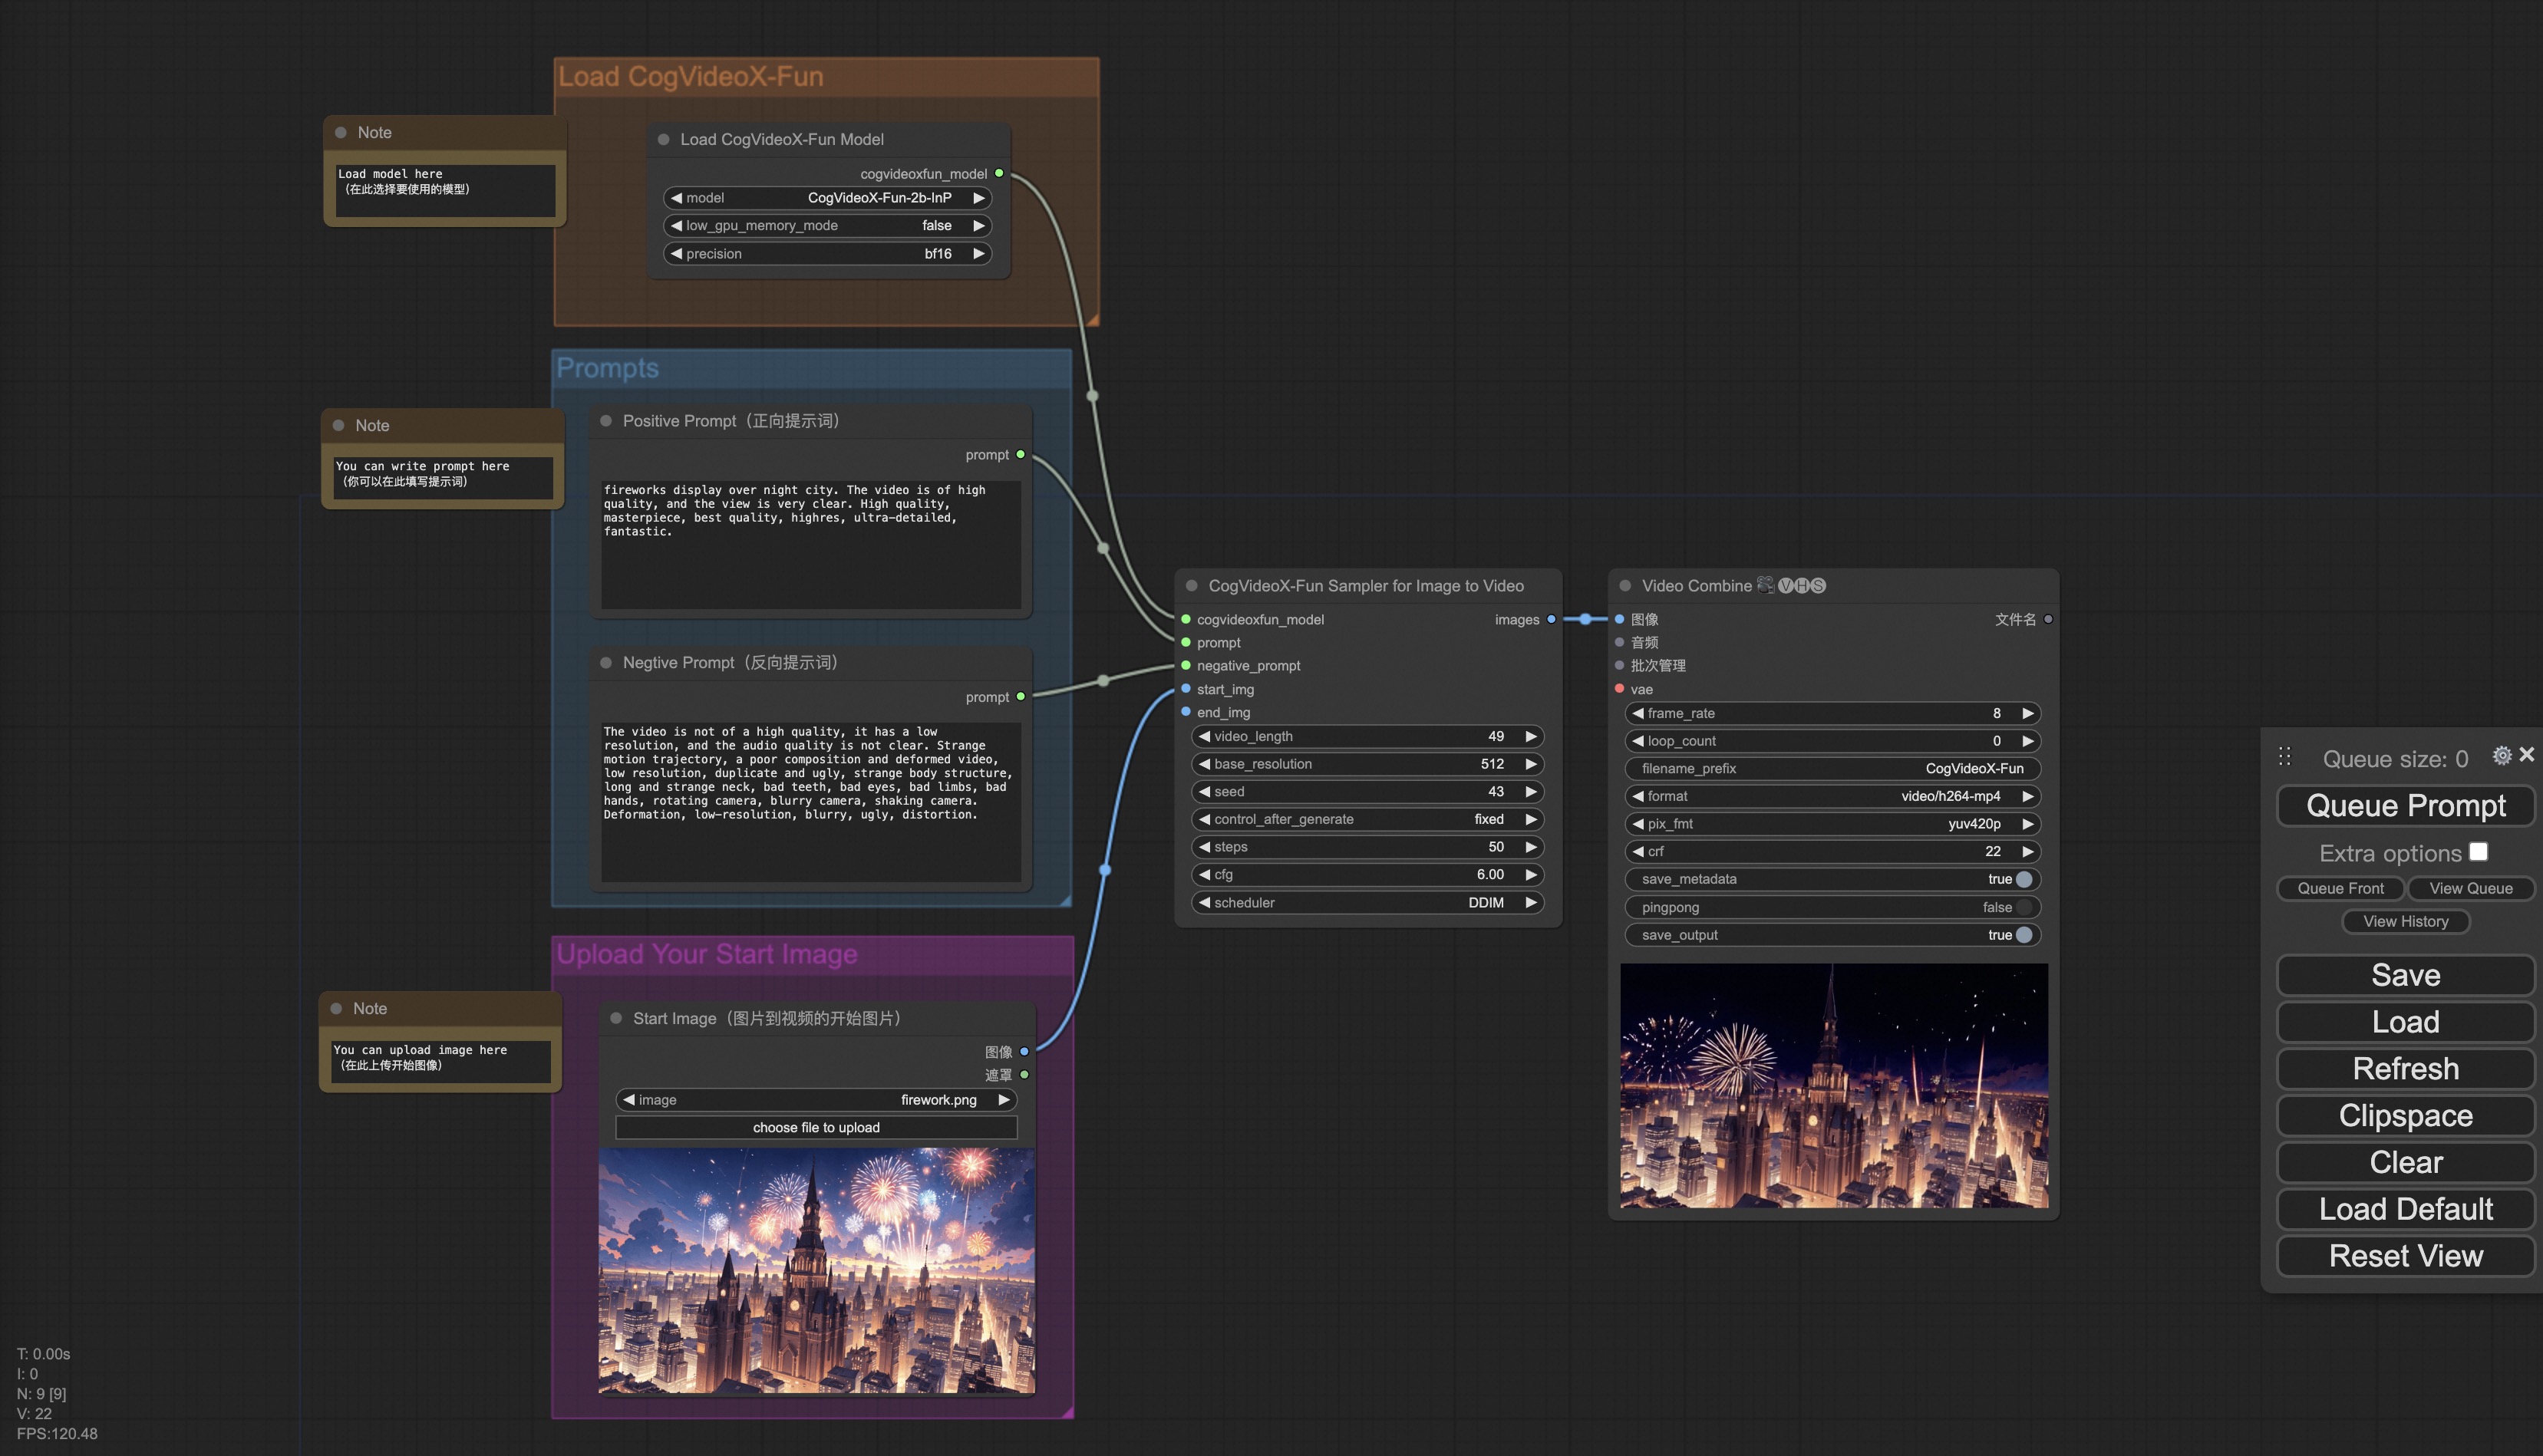
我们的ComfyUI界面如下,具体查看ComfyUI README。
使用docker的情况下,请保证机器中已经正确安装显卡驱动与CUDA环境,然后以此执行以下命令:
# pull image
docker pull mybigpai-public-registry.cn-beijing.cr.aliyuncs.com/easycv/torch_cuda:cogvideox_fun

# enter image
docker run -it -p 7860:7860 --network host --gpus all --security-opt seccomp:unconfined --shm-size 200g mybigpai-public-registry.cn-beijing.cr.aliyuncs.com/easycv/torch_cuda:cogvideox_fun

# clone code
git clone https://github.com/aigc-apps/CogVideoX-Fun.git

# enter CogVideoX-Fun's dir
cd CogVideoX-Fun

# download weights
mkdir models/Diffusion_Transformer
mkdir models/Personalized_Model

wget https://pai-aigc-photog.oss-cn-hangzhou.aliyuncs.com/cogvideox_fun/Diffusion_Transformer/CogVideoX-Fun-2b-InP.tar.gz -O models/Diffusion_Transformer/CogVideoX-Fun-2b-InP.tar.gz

cd models/Diffusion_Transformer/
tar -xvf CogVideoX-Fun-2b-InP.tar.gz
cd ../../
我们已验证CogVideoX-Fun可在以下环境中执行:
Windows 的详细信息:
Linux 的详细信息:
我们需要大约 60GB 的可用磁盘空间,请检查!
我们最好将权重按照指定路径进行放置:
📦 models/
├── 📂 Diffusion_Transformer/
│   ├── 📂 CogVideoX-Fun-2b-InP/
│   └── 📂 CogVideoX-Fun-5b-InP/
├── 📂 Personalized_Model/
│   └── your trained trainformer model / your trained lora model (for UI load)
所展示的结果都是图生视频获得。
Resolution-1024
<table border="0" style="width: 100%; text-align: left; margin-top: 20px;"> <tr> <td> <video src="https://github.com/user-attachments/assets/ec749326-b529-453f-a4b4-f587875dff64" width="100%" controls autoplay loop></video> </td> <td> <video src="https://github.com/user-attachments/assets/84df4178-f493-4aa8-a888-d2020338da82" width="100%" controls autoplay loop></video> </td> <td> <video src="https://github.com/user-attachments/assets/c66c139d-94d3-4930-985b-60e3e0600d8f" width="100%" controls autoplay loop></video> </td> <td> <video src="https://github.com/user-attachments/assets/647c0e0c-28d6-473e-b4eb-a30197dddefc" width="100%" controls autoplay loop></video> </td> </tr> </table>Resolution-768
<table border="0" style="width: 100%; text-align: left; margin-top: 20px;"> <tr> <td> <video src="https://github.com/user-attachments/assets/647d45b0-4253-4438-baf3-f692789bde78" width="100%" controls autoplay loop></video> </td> <td> <video src="https://github.com/user-attachments/assets/e5a5a948-5c34-445d-9446-324a666a6a33" width="100%" controls autoplay loop></video> </td> <td> <video src="https://github.com/user-attachments/assets/0e605797-4a86-4e0c-8589-40ed686d97a4" width="100%" controls autoplay loop></video> </td> <td> <video src="https://github.com/user-attachments/assets/5356bf79-0a3b-4caf-ac31-2d796e20e429" width="100%" controls autoplay loop></video> </td> </tr> </table>Resolution-512
<table border="0" style="width: 100%; text-align: left; margin-top: 20px;"> <tr> <td> <video src="https://github.com/user-attachments/assets/5a9f3457-fe82-4082-8494-d8f4f8db75e9" width="100%" controls autoplay loop></video> </td> <td> <video src="https://github.com/user-attachments/assets/ca6874b8-41d1-4f02-bee3-4fc886f309ad" width="100%" controls autoplay loop></video> </td> <td> <video src="https://github.com/user-attachments/assets/9216b348-2c80-4eab-9c1c-dd3a54b7ea1e" width="100%" controls autoplay loop></video> </td> <td> <video src="https://github.com/user-attachments/assets/e99ec495-655f-44d8-afa7-3ad0a14f9975" width="100%" controls autoplay loop></video> </td> </tr> </table>Resolution-768
<table border="0" style="width: 100%; text-align: left; margin-top: 20px;"> <tr> <td> <video src="https://github.com/user-attachments/assets/d329b4d4-f08f-4e77-887e-049cfc93a908" width="100%" controls autoplay loop></video> </td> <td> <video src="https://github.com/user-attachments/assets/dd7fa2d5-9871-436c-ae5a-44f1494c9c9f" width="100%" controls autoplay loop></video> </td> <td> <video src="https://github.com/user-attachments/assets/c24a2fa2-2fe3-4277-aa9f-e812a2cf0a4e" width="100%" controls autoplay loop></video> </td> <td> <video src="https://github.com/user-attachments/assets/573edac3-8bd0-4e95-82df-bcfdcba9a73f" width="100%" controls autoplay loop></video> </td> </tr> </table>具体查看ComfyUI README。
一个完整的CogVideoX-Fun训练链路应该包括数据预处理和Video DiT训练。
<h4 id="data-preprocess">a.数据预处理</h4> 我们给出了一个简单的demo通过图片数据训练lora模型,详情可以查看[wiki](https://github.com/aigc-apps/CogVideoX-Fun/wiki/Training-Lora)。一个完整的长视频切分、清洗、描述的数据预处理链路可以参考video caption部分的README进行。
如果期望训练一个文生图视频的生成模型,您需要以这种格式排列数据集。
📦 project/
├── 📂 datasets/
│   ├── 📂 internal_datasets/
│       ├── 📂 train/
│       │   ├── 📄 00000001.mp4
│       │   ├── 📄 00000002.jpg
│       │   └── 📄 .....
│       └── 📄 json_of_internal_datasets.json
json_of_internal_datasets.json是一个标准的json文件。json中的file_path可以被设置为相对路径,如下所示:
[
    {
      "file_path": "train/00000001.mp4",
      "text": "A group of young men in suits and sunglasses are walking down a city street.",
      "type": "video"
    },
    {
      "file_path": "train/00000002.jpg",
      "text": "A group of young men in suits and sunglasses are walking down a city street.",
      "type": "image"
    },
    .....
]
你也可以将路径设置为绝对路径:
[
    {
      "file_path": "/mnt/data/videos/00000001.mp4",
      "text": "A group of young men in suits and sunglasses are walking down a city street.",
      "type": "video"
    },
    {
      "file_path": "/mnt/data/train/00000001.jpg",
      "text": "A group of young men in suits and sunglasses are walking down a city street.",
      "type": "image"
    },
    .....
]
如果数据预处理时,数据的格式为相对路径,则进入scripts/train.sh进行如下设置。
export DATASET_NAME="datasets/internal_datasets/"
export DATASET_META_NAME="datasets/internal_datasets/json_of_internal_datasets.json"

...

train_data_format="normal"
如果数据的格式为绝对路径,则进入scripts/train.sh进行如下设置。
export DATASET_NAME=""
export DATASET_META_NAME="/mnt/data/json_of_internal_datasets.json"
最后运行scripts/train.sh。
sh scripts/train.sh
关于一些参数的设置细节,可以查看Readme Train与Readme Lora
| 名称 | 存储空间 | Hugging Face | Model Scope | 描述 |
|---|---|---|---|---|
| CogVideoX-Fun-2b-InP.tar.gz | 解压前 9.7 GB / 解压后 13.0 GB | 🤗Link | 😄Link | 官方的图生视频权重。支持多分辨率(512,768,1024,1280)的视频预测,以49帧、每秒8帧进行训练 |
| CogVideoX-Fun-5b-InP.tar.gz | 解压前 16.0GB / 解压后 20.0 GB | 🤗Link | 😄Link | 官方的图生视频权重。支持多分辨率(512,768,1024,1280)的视频预测,以49帧、每秒8帧进行训练 |
本项目采用 Apache License (Version 2.0).
CogVideoX-2B 模型 (包括其对应的Transformers模块,VAE模块) 根据 Apache 2.0 协议 许可证发布。
CogVideoX-5B 模型(Transformer 模块)在CogVideoX许可证下发布.