
Downloads · 30 days
92
26% of all-time downloads
aaa961/finetuned-bge-m3-base-en
finetuned-bge-m3-base-en is a sentence similarity model from aaa961. Use it when you need a score for how close two texts are. It is set up for sentence-transformers.
This is a sentence-transformers model finetuned from BAAI/bge-m3. It maps sentences & paragraphs to a 1024-dimensional dense vector space and can be used for semantic textual similarity, semantic search, paraphrase mi…
Downloads · 30 days
92
26% of all-time downloads
All-time downloads
355
Public
Parameters
568M
2.3 GB on disk
Likes
0
Public
Click a slice to open those files.
.safetensors2.3 GB · 99%
From the Hugging Face model README
This is a sentence-transformers model finetuned from BAAI/bge-m3. It maps sentences & paragraphs to a 1024-dimensional dense vector space and can be used for semantic textual similarity, semantic search, paraphrase mining, text classification, clustering, and more.
SentenceTransformer(
  (0): Transformer({'max_seq_length': 8192, 'do_lower_case': False, 'architecture': 'XLMRobertaModel'})
  (1): Pooling({'word_embedding_dimension': 1024, 'pooling_mode_cls_token': True, 'pooling_mode_mean_tokens': False, 'pooling_mode_max_tokens': False, 'pooling_mode_mean_sqrt_len_tokens': False, 'pooling_mode_weightedmean_tokens': False, 'pooling_mode_lasttoken': False, 'include_prompt': True})
  (2): Normalize()
)
First install the Sentence Transformers library:
pip install -U sentence-transformers
Then you can load this model and run inference.
from sentence_transformers import SentenceTransformer
# Download from the 🤗 Hub
model = SentenceTransformer("aaa961/finetuned-bge-m3-base-en")
# Run inference
sentences = [
'Shell integration: bash and zsh don\'t serialize \\n and ; characters Part of https://github.com/microsoft/vscode/issues/155639\r\n\r\nRepro:\r\n\r\n1. Open a bash or zsh session\r\n2. Run:\r\n ```sh\r\n echo "a\r\n … b"\r\n ```\r\n \r\n3. ctrl+alt+r to run recent command, select the last command, 🐛 it\'s run without the new line\r\n \r\n',
'TreeView state out of sync Testing #117304\r\n\r\nRepro: Not Sure\r\n\r\nTest state shows passed in file but still running in tree view.\r\n\r\n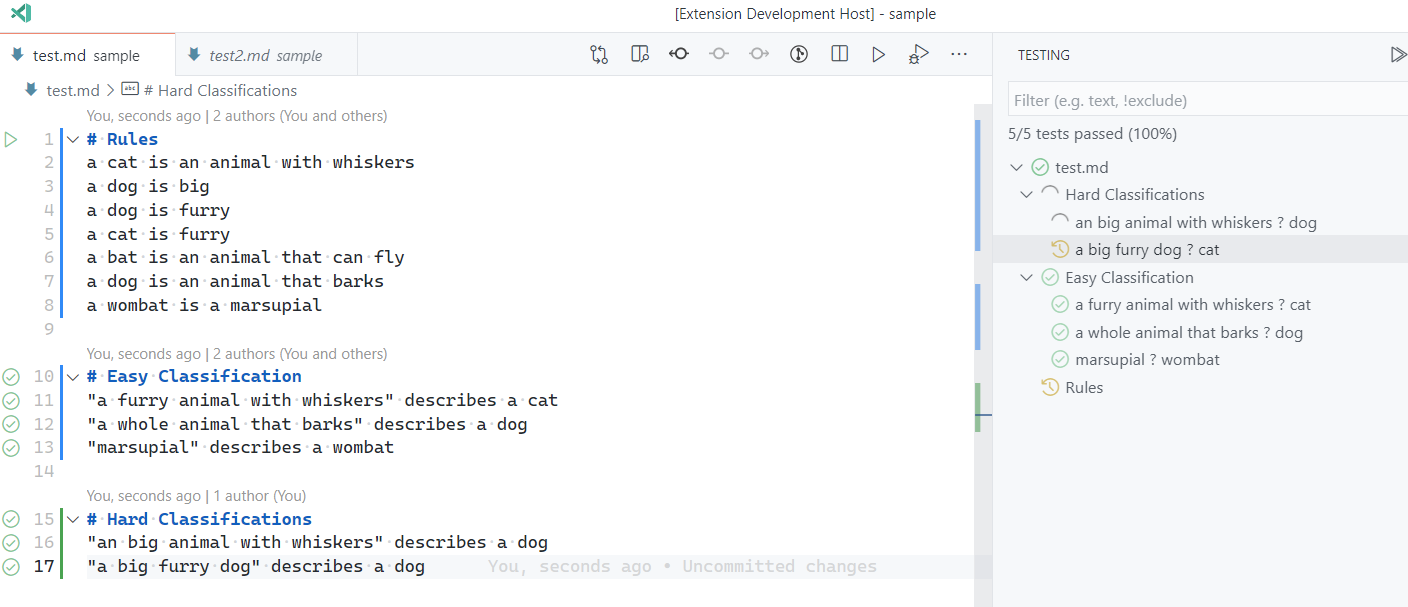\r\n',
'Setting icon and color in createTerminal API no longer works correctly See https://github.com/fabiospampinato/vscode-terminals/issues/77\r\n\r\nLooks like the default tab color/icon change probably regressed this.\r\n\r\n',
]
embeddings = model.encode(sentences)
print(embeddings.shape)
# [3, 1024]
# Get the similarity scores for the embeddings
similarities = model.similarity(embeddings, embeddings)
print(similarities)
# tensor([[1.0000, 0.4264, 0.4315],
# [0.4264, 1.0000, 0.4278],
# [0.4315, 0.4278, 1.0000]])
bge-base-en-train| Metric | Value |
|---|---|
| cosine_accuracy | 1.0 |
bge-base-en-train| Metric | Value |
|---|---|
| cosine_accuracy | 0.9524 |
| texts | label | |
|---|---|---|
| type | string | int |
| details | <ul><li>min: 12 tokens</li><li>mean: 340.9 tokens</li><li>max: 996 tokens</li></ul> | <ul><li>0: ~1.19%</li><li>5: ~0.60%</li><li>7: ~0.60%</li><li>8: ~0.60%</li><li>9: ~0.60%</li><li>10: ~0.60%</li><li>12: ~0.60%</li><li>13: ~0.60%</li><li>15: ~0.60%</li><li>16: ~0.60%</li><li>17: ~0.60%</li><li>19: ~0.60%</li><li>20: ~0.60%</li><li>21: ~0.60%</li><li>25: ~0.60%</li><li>26: ~0.60%</li><li>27: ~0.60%</li><li>28: ~0.60%</li><li>29: ~0.89%</li><li>30: ~0.89%</li><li>31: ~2.08%</li><li>33: ~1.49%</li><li>34: ~0.60%</li><li>36: ~0.60%</li><li>37: ~0.89%</li><li>38: ~0.60%</li><li>42: ~0.89%</li><li>43: ~1.19%</li><li>45: ~0.60%</li><li>47: ~0.60%</li><li>48: ~0.60%</li><li>49: ~0.60%</li><li>50: ~0.60%</li><li>51: ~0.60%</li><li>52: ~1.19%</li><li>53: ~0.60%</li><li>55: ~0.60%</li><li>57: ~1.19%</li><li>59: ~0.60%</li><li>60: ~0.60%</li><li>61: ~0.60%</li><li>62: ~0.60%</li><li>63: ~0.60%</li><li>64: ~0.89%</li><li>65: ~0.60%</li><li>67: ~0.60%</li><li>68: ~0.89%</li><li>69: ~0.60%</li><li>70: ~0.60%</li><li>71: ~0.60%</li><li>72: ~0.60%</li><li>73: ~0.60%</li><li>74: ~0.60%</li><li>75: ~0.60%</li><li>77: ~0.60%</li><li>78: ~0.60%</li><li>82: ~0.89%</li><li>84: ~0.60%</li><li>85: ~0.60%</li><li>86: ~0.60%</li><li>87: ~0.60%</li><li>88: ~0.60%</li><li>89: ~0.60%</li><li>90: ~0.60%</li><li>91: ~0.60%</li><li>92: ~0.89%</li><li>93: ~0.60%</li><li>95: ~0.60%</li><li>96: ~0.60%</li><li>97: ~0.60%</li><li>98: ~0.60%</li><li>99: ~0.60%</li><li>100: ~0.60%</li><li>101: ~0.60%</li><li>103: ~0.60%</li><li>105: ~0.60%</li><li>108: ~0.60%</li><li>109: ~0.60%</li><li>110: ~0.89%</li><li>113: ~0.60%</li><li>115: ~0.60%</li><li>116: ~0.60%</li><li>117: ~0.60%</li><li>118: ~0.60%</li><li>119: ~0.60%</li><li>120: ~1.49%</li><li>121: ~0.60%</li><li>126: ~0.60%</li><li>127: ~0.60%</li><li>130: ~0.60%</li><li>131: ~0.60%</li><li>134: ~0.60%</li><li>135: ~0.60%</li><li>136: ~0.60%</li><li>137: ~0.60%</li><li>138: ~0.60%</li><li>139: ~0.60%</li><li>140: ~0.60%</li><li>143: ~0.60%</li><li>144: ~0.60%</li><li>147: ~0.60%</li><li>148: ~0.60%</li><li>149: ~0.60%</li><li>150: ~0.60%</li><li>152: ~0.60%</li><li>153: ~0.60%</li><li>154: ~0.60%</li><li>155: ~0.60%</li><li>157: ~0.60%</li><li>158: ~0.60%</li><li>159: ~0.60%</li><li>160: ~0.60%</li><li>161: ~0.60%</li><li>163: ~0.60%</li><li>164: ~0.60%</li><li>165: ~0.60%</li><li>168: ~0.60%</li><li>170: ~0.60%</li><li>171: ~0.89%</li><li>174: ~0.89%</li><li>175: ~0.60%</li><li>176: ~0.60%</li><li>177: ~0.60%</li><li>178: ~0.60%</li><li>179: ~0.60%</li><li>180: ~0.60%</li><li>181: ~0.60%</li><li>182: ~0.60%</li><li>183: ~0.60%</li><li>185: ~0.60%</li><li>186: ~0.60%</li><li>187: ~0.60%</li><li>192: ~0.60%</li><li>193: ~0.60%</li><li>194: ~0.60%</li><li>195: ~0.89%</li><li>196: ~0.60%</li><li>197: ~0.60%</li><li>198: ~0.60%</li><li>199: ~0.60%</li><li>202: ~0.60%</li><li>204: ~0.60%</li><li>205: ~0.89%</li><li>207: ~0.60%</li><li>208: ~0.60%</li><li>209: ~0.60%</li><li>210: ~0.60%</li><li>213: ~0.60%</li><li>214: ~0.60%</li><li>215: ~0.60%</li><li>216: ~0.60%</li><li>218: ~0.60%</li></ul> |
| texts | label |
|---|---|
| <code>Branch list is sometimes out of order | |
| <br>Type: <b>Bug</b> |
| texts | label | |
|---|---|---|
| type | string | int |
| details | <ul><li>min: 58 tokens</li><li>mean: 303.57 tokens</li><li>max: 864 tokens</li></ul> | <ul><li>1: ~2.86%</li><li>2: ~2.86%</li><li>6: ~2.86%</li><li>11: ~5.71%</li><li>14: ~2.86%</li><li>23: ~2.86%</li><li>32: ~5.71%</li><li>35: ~2.86%</li><li>39: ~2.86%</li><li>40: ~2.86%</li><li>46: ~2.86%</li><li>54: ~2.86%</li><li>83: ~2.86%</li><li>102: ~2.86%</li><li>104: ~4.29%</li><li>111: ~2.86%</li><li>122: ~2.86%</li><li>123: ~2.86%</li><li>125: ~2.86%</li><li>145: ~2.86%</li><li>146: ~2.86%</li><li>162: ~2.86%</li><li>166: ~2.86%</li><li>169: ~2.86%</li><li>184: ~2.86%</li><li>188: ~2.86%</li><li>190: ~2.86%</li><li>200: ~2.86%</li><li>201: ~4.29%</li><li>203: ~2.86%</li><li>206: ~2.86%</li><li>217: ~2.86%</li></ul> |
| texts | label |
|---|---|
| <code>Ctrl+I stopped working after first hold+talk+release Testing #213355 |
eval_strategy: stepsper_device_train_batch_size: 1per_device_eval_batch_size: 1gradient_accumulation_steps: 8learning_rate: 2e-05num_train_epochs: 5warmup_ratio: 0.1fp16: Truebatch_sampler: no_duplicatesoverwrite_output_dir: Falsedo_predict: Falseeval_strategy: stepsprediction_loss_only: Trueper_device_train_batch_size: 1per_device_eval_batch_size: 1per_gpu_train_batch_size: Noneper_gpu_eval_batch_size: Nonegradient_accumulation_steps: 8eval_accumulation_steps: Nonetorch_empty_cache_steps: Nonelearning_rate: 2e-05weight_decay: 0.0adam_beta1: 0.9adam_beta2: 0.999adam_epsilon: 1e-08max_grad_norm: 1.0num_train_epochs: 5max_steps: -1lr_scheduler_type: linearlr_scheduler_kwargs: {}warmup_ratio: 0.1warmup_steps: 0log_level: passivelog_level_replica: warninglog_on_each_node: Truelogging_nan_inf_filter: Truesave_safetensors: Truesave_on_each_node: Falsesave_only_model: Falserestore_callback_states_from_checkpoint: Falseno_cuda: Falseuse_cpu: Falseuse_mps_device: Falseseed: 42data_seed: Nonejit_mode_eval: Falseuse_ipex: Falsebf16: Falsefp16: Truefp16_opt_level: O1half_precision_backend: autobf16_full_eval: Falsefp16_full_eval: Falsetf32: Nonelocal_rank: 0ddp_backend: Nonetpu_num_cores: Nonetpu_metrics_debug: Falsedebug: []dataloader_drop_last: Falsedataloader_num_workers: 0dataloader_prefetch_factor: Nonepast_index: -1disable_tqdm: Falseremove_unused_columns: Truelabel_names: Noneload_best_model_at_end: Falseignore_data_skip: Falsefsdp: []fsdp_min_num_params: 0fsdp_config: {'min_num_params': 0, 'xla': False, 'xla_fsdp_v2': False, 'xla_fsdp_grad_ckpt': False}fsdp_transformer_layer_cls_to_wrap: Noneaccelerator_config: {'split_batches': False, 'dispatch_batches': None, 'even_batches': True, 'use_seedable_sampler': True, 'non_blocking': False, 'gradient_accumulation_kwargs': None}deepspeed: Nonelabel_smoothing_factor: 0.0optim: adamw_torchoptim_args: Noneadafactor: Falsegroup_by_length: Falselength_column_name: lengthddp_find_unused_parameters: Noneddp_bucket_cap_mb: Noneddp_broadcast_buffers: Falsedataloader_pin_memory: Truedataloader_persistent_workers: Falseskip_memory_metrics: Trueuse_legacy_prediction_loop: Falsepush_to_hub: Falseresume_from_checkpoint: Nonehub_model_id: Nonehub_strategy: every_savehub_private_repo: Nonehub_always_push: Falsehub_revision: Nonegradient_checkpointing: Falsegradient_checkpointing_kwargs: Noneinclude_inputs_for_metrics: Falseinclude_for_metrics: []eval_do_concat_batches: Truefp16_backend: autopush_to_hub_model_id: Nonepush_to_hub_organization: Nonemp_parameters:auto_find_batch_size: Falsefull_determinism: Falsetorchdynamo: Noneray_scope: lastddp_timeout: 1800torch_compile: Falsetorch_compile_backend: Nonetorch_compile_mode: Noneinclude_tokens_per_second: Falseinclude_num_input_tokens_seen: Falseneftune_noise_alpha: Noneoptim_target_modules: Nonebatch_eval_metrics: Falseeval_on_start: Falseuse_liger_kernel: Falseliger_kernel_config: Noneeval_use_gather_object: Falseaverage_tokens_across_devices: Falseprompts: Nonebatch_sampler: no_duplicatesmulti_dataset_batch_sampler: proportionalrouter_mapping: {}learning_rate_mapping: {}| Epoch | Step | Training Loss | Validation Loss | bge-base-en-train_cosine_accuracy |
|---|---|---|---|---|
| -1 | -1 | - | - | 1.0 |
| 2.3810 | 100 | 0.0 | nan | 0.9524 |
| 4.7619 | 200 | 0.0 | nan | 0.9524 |
| -1 | -1 | - | - | 1.0 |
@inproceedings{reimers-2019-sentence-bert,
    title = "Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks",
    author = "Reimers, Nils and Gurevych, Iryna",
    booktitle = "Proceedings of the 2019 Conference on Empirical Methods in Natural Language Processing",
    month = "11",
    year = "2019",
    publisher = "Association for Computational Linguistics",
    url = "https://arxiv.org/abs/1908.10084",
}
@misc{hermans2017defense,
    title={In Defense of the Triplet Loss for Person Re-Identification},
    author={Alexander Hermans and Lucas Beyer and Bastian Leibe},
    year={2017},
    eprint={1703.07737},
    archivePrefix={arXiv},
    primaryClass={cs.CV}
}